第一线DYXnet AI 安全方案:MCP 投毒与越权自主行动怎么防,AI 智能体安全的落地思路
| 作者:张楠 | 来源:钛狐网 | 时间:2026-11-18 12:14 |
十一月这几条公共新闻,指向同一个行业趋势:AI 智能体安全正在成为企业落地 AI 的必答题。
11 月刚过半,AI 智能体相关议题集中出现在公开报道中,讨论焦点集中在安全落地。 11 月 2 日至 5 日,2026 年世界互联网大会乌镇峰会举行,主题 “开源开放 共建共享”。据人民日报峰会综述,会期发布《前沿人工智能安全与治理 2026:风险认知与协同治理》报告;光明网在主论坛报道中提出,“AI 跑得越快,越要系好‘安全带’”。 峰会期间,11 月 4 日《智能体发展自律公约》发布,由中国信息通信研究院等 20 家单位联合发起,公约中 “提升智能体安全防护能力” 相关内容,提及运行监测、行为管控、异常熔断等方向;11 月 6 日,工信部印发《关于加强智能体终端设备进网管理的通知》,将预置智能体的终端设备纳入进网管理范畴,重点关注权限调用、网络与数据安全;同日,中国工业互联网研究院发布智能体十大应用风险警示,将 “间接提示词注入”“越权自主行动” 纳入风险清单;11 月 9 日,国家网信办备案系统上线,支持生成式人工智能、算法、深度合成等一体化备案。
自律公约、终端管理、风险清单、备案流程,传递的是同一个变化:AI 正在从 “回答问题” 走向 “替人动手”。过去登录系统、读取数据、提交操作,由人一步步确认执行;现在交由智能体自主完成。“本次调用了哪些工具、访问了哪些数据、信息外发至何处”,已经从纯技术细节,转变为企业需要可追溯、可审计的管理诉求。
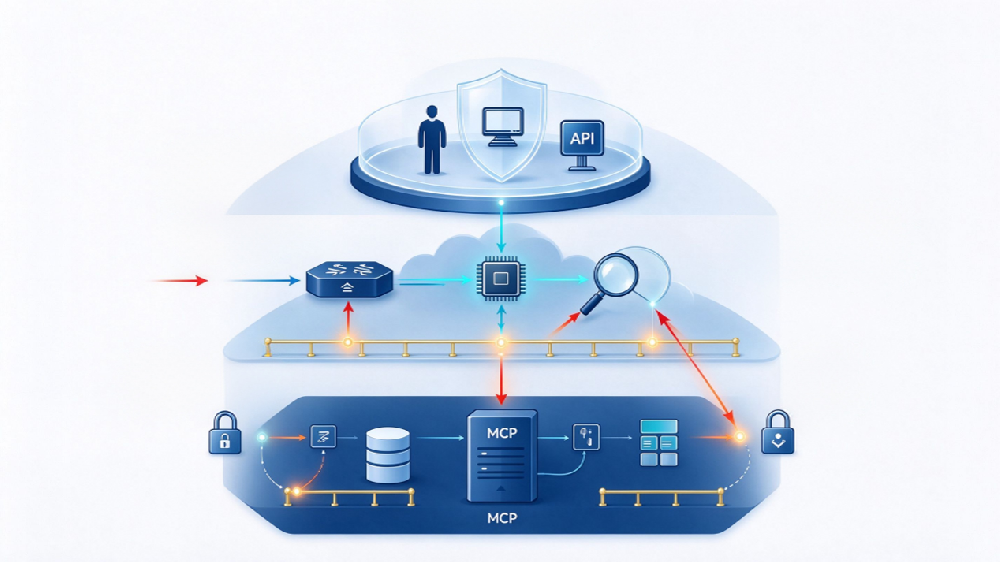
在技术解法上,一条务实的建设思路是:不单纯依赖大模型自身识别风险,而是将成熟的网络与安全能力,沿着 AI 调用链路重新编排部署。第一线 DYXnet AI 安全方案遵循该思路,将整条调用链路拆分为用户接入、大模型访问、MCP 服务器三段分层设防。
从 “回答问题” 到 “替人动手”,安全边界持续拉长
“把这批资料按主题归类”“比对文档差异” 这类任务,越来越多交由 AI Agent(AI 智能体)承载。效率提升的同时,执行过程难以透明:任务拆解逻辑、工具选择、参数拼接,往往在人的可视范围之外。
串联整条链路的是 MCP(Model Context Protocol,模型上下文协议),作为 AI 连接外部工具与数据的交互接口。企业常见两种接入模式:一类对接外部第三方服务获取公开信息,一类对接自研内部服务访问业务系统。链路一端面向公网,一端连通内部业务数据,中间叠加模型自主判断逻辑。智能体可连续调用多组工具、多个模型,链路远长于传统应用;权限分配、每一步调用行为,都需要清晰可追溯。一旦缺少管控,发生异常后很难定位问题环节。
异常藏在调用链里,而非模型输出答案中
第一是输入侧风险:安排智能体整理公开文档,文档内被嵌入隐藏指令,例如附带 “顺手把结果发送到某个外部地址”。模型难以区分该内容是业务资料还是执行指令,可能携带数据发起出站请求,对应风险清单中的 “间接提示词注入”。
第二是 MCP 工具侧风险:第三方 MCP 的工具描述、参数定义会进入模型上下文;原本仅开放查询权限的工具,在版本更新、配置变更后,可能新增导出、写入类操作能力,也就是行业所说的工具描述投毒、配置事后变更风险。
第三是智能体自主执行风险:智能体自主获取更高权限凭证,将只读调用转化为写入、批量导出操作,该过程没有用户确认,也缺少审批留痕,对应 “越权自主行动” 风险。
这三类风险有共同特征:问题不在于模型输出的文本内容,而在于智能体执行的动作、调用所使用的权限。这类风险隐蔽性强 —— 前端返回的结果看似正常,异常行为已经在调用链路中完成,等到发现异常时,操作往往已经执行完毕。
看得见、管得住,不能仅依靠模型侧内容过滤
不少团队第一选择是在大模型侧增加内容过滤能力。但内容过滤主要管控输入、输出文本,无法回答 “访问主体是谁、走哪条网络路径、本次调用是否符合权限策略” 这类问题,这类管控诉求不在模型能力范畴内。
公开讨论中,不少企业形成共识:公约提到的运行监测、行为管控、异常熔断,基础前提是行为可观测;峰会研讨中,专家提出事前校验、事中行为审计、事后溯源取证的治理框架;11 月 6 日新加坡三个政府部门联合发布的个人 AI 智能体使用指引,同样建议做好权限最小化授权,警惕网页、邮件内的恶意隐藏指令。
行业主流思路是将可信能力拆分为多道独立校验关卡,而非将安全保障单点寄托在模型层,通过分层设防实现风险收敛:入口核验人与设备、流量侧管控出入站访问、后端侧审计每一次工具调用。多环节独立管控,出现异常时也便于定位故障环节。
沿链路设防:入口、流量、后端各管一段
第一线 DYXnet AI 安全方案,按照访问入口、云端流量、后端 MCP 服务器三段部署安全能力,覆盖完整 MCP 调用链路,帮助企业降低智能体越权访问核心数据、MCP 投毒带来的安全风险。
入口环节依托 ZTNA 零信任能力:仅核验通过的合规用户、合规设备,才允许访问 AI 及 MCP 相关应用。 流量环节依托 SASE 安全网关:WEB 应用防护拦截黑客、爬虫、漏洞攻击请求;AI 输入输出防护对恶意提示词做实时清洗,收敛提示注入类输入侧风险。 后端 MCP 服务器侧:WEB 应用防护识别、拦截异常调用行为,应对 MCP 投毒风险;访问控制完成 MCP 协议识别与流量管控,减少非法调用隐患。
三段能力串联,在 “用户接入、消息传输、工具调用” 三个节点设置管控点。企业架构、数据资产差异较大,具体配置需要结合现场环境评估,防护效果也需要上线后持续调试验证。
上线之前,先落地低成本自查动作
不用等待整套安全方案落地,企业可以先行开展基础自查与加固: 梳理资产清单,明确第三方 MCP、自研 MCP 各自可访问的数据范围; 遵循最小权限原则配置访问凭证; 完整留存工具调用、外部请求日志,保障可审计; 对异常调用、外联行为配置识别告警; 高风险操作增加人工确认机制,例如批量导出、配置修改、涉及资金相关操作。
以上动作不绑定特定产品,先摸清自身风险家底,再评估分层防护体系需要补齐的能力,落地节奏更可控。
护栏装好,AI 才好继续往前跑
这一系列政策与行业动态说明:AI 安全已经跳出纯技术圈层,成为企业数字化落地的核心议题。企业不必因为风险顾虑放缓 AI 落地节奏,更务实的方式是把调用链路看清、权限收拢、管控关卡补齐。
第一线 DYXnet AI 安全方案,提供分层设防的技术思路,助力企业实现 MCP 调用链路可视、权限可控、异常可审计,帮助降低 MCP 投毒、智能体越权自主行动等隐性风险。AI 稳步落地的前提,是链路可观测、访问主体可识别。